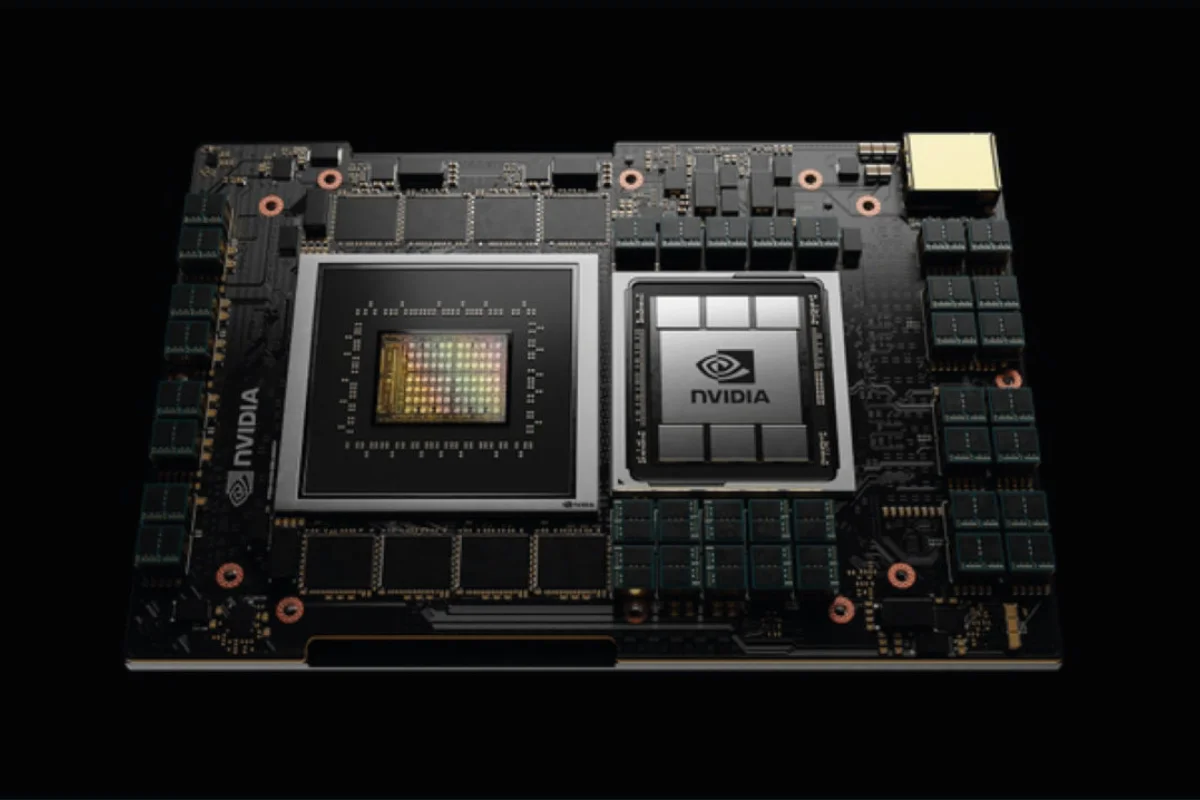

La empresa estadounidense d-Matrix anunció el 10 de septiembre que utilizará la tecnología NVLink Fusion de NVIDIA para integrar sus procesadores Raptor especializados en inferencia de inteligencia artificial dentro de sistemas de centros de datos. Los nuevos servidores estarán orientados a aplicaciones que necesitan procesar respuestas en tiempo real, como chatbots, asistentes de programación y agentes de voz.
El anuncio refleja un cambio importante dentro de la infraestructura de inteligencia artificial. Hasta ahora, gran parte de la atención se ha concentrado en el entrenamiento de modelos, proceso que requiere enormes cantidades de capacidad de cómputo. Sin embargo, una vez que un modelo está desarrollado, también necesita infraestructura para responder a las solicitudes de los usuarios. Esa etapa se conoce como inferencia.
d-Matrix se especializa precisamente en este segundo proceso. Sus chips Raptor están diseñados para ejecutar modelos de inteligencia artificial con baja latencia, es decir, reduciendo el tiempo que transcurre entre una solicitud y la generación de una respuesta. Esto resulta especialmente importante para servicios en los que los usuarios esperan una interacción prácticamente inmediata.
NVLink Fusion permitirá conectar chips diseñados por terceros con la infraestructura de servidores de NVIDIA mediante conexiones y memoria especializadas. De esta manera, los procesadores de d-Matrix podrán incorporarse a sistemas de centros de datos compatibles con la tecnología de NVIDIA, en lugar de funcionar como plataformas completamente independientes.
Los sistemas compatibles con los procesadores Raptor están previstos para estar disponibles en 2027. La startup espera completar el diseño final de sus chips hacia finales de 2026. Los términos financieros del acuerdo con NVIDIA no fueron revelados.
La colaboración ocurre mientras la demanda de infraestructura para inteligencia artificial continúa creciendo. Las empresas tecnológicas necesitan procesar cada vez más consultas generadas por asistentes digitales, herramientas de programación, sistemas empresariales y aplicaciones capaces de interactuar mediante voz.
Una de las diferencias entre entrenamiento e inferencia es precisamente el tipo de infraestructura que requieren. El entrenamiento de modelos puede demandar grandes cantidades de capacidad de procesamiento durante periodos prolongados, mientras que la inferencia busca responder a solicitudes individuales de manera eficiente y rápida.
Para los usuarios, este tipo de desarrollo puede tener consecuencias indirectas. Una infraestructura especializada podría ayudar a que determinadas aplicaciones de inteligencia artificial respondan con menor retraso y puedan operar a mayor escala. Sin embargo, la velocidad final también depende del modelo utilizado, la conexión, el software y la infraestructura completa del servicio.
d-Matrix también trabaja con Astera Labs en soluciones destinadas a mejorar el flujo de datos dentro de estos sistemas. La empresa, con sede en Santa Clara, California, recibió respaldo de Microsoft y alcanzó una valoración de 2,000 millones de dólares después de una ronda de financiamiento de 450 millones de dólares en 2025.
El movimiento muestra que la competencia en inteligencia artificial ya no se concentra únicamente en desarrollar mejores modelos. La capacidad de ejecutarlos de forma rápida, eficiente y a gran escala también se ha convertido en una pieza central de la evolución tecnológica.